DeepSeek V4.1发布!成本降至竞品1/50,性能大幅飙升
DeepSeek发布V4.1 Flash-1017大模型,性能大幅提升。该模型在AI斩杀线表现封神,每任务成本仅为Fable、Astra等大模型的1/50-1/100,性价比高出四五十倍。DeepSeek凭借极强的AI优化能力,在硬件优化上表现突出,在GB300 NVL72及Dynamo vLLM平台上,V4.1 Flash跑出1美元1.3B Token的成绩
现在发布了那个V4.1以及Flash-1017这样的大模型, 在大家都非常期待国产的AI大模型会有新版本更新的时候, 这边率先把版本给推出了, 这次升级会带来大幅度的性能提升。
关于具体的性能水平以及相应的变化, 之前已经有过报道, 所以大家应该会注意到这次自己还发出了一张帕累托曲线图, 这就是大家平常所说的AI斩杀线。
对于V4.1 Flash-1017来说, 这一次的结果堪称是封神一般的存在, 其中每个任务所使用的成本仅仅只占Fable、Astra这样的大模型的五十分之一到百分之一之间, 整体的性价比至少要比它们高出四五十倍之多。
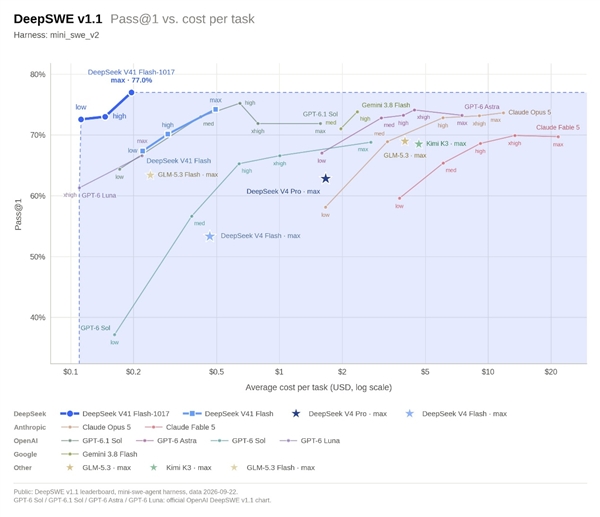
到底是怎么做到有这么高的斩杀线的呢? 大家都很清楚, 他们拥有非常强大的人工智能优化能力, 在把成本降下来的这方面真的是费尽了心思, 而下面发布的那一张图可以清清楚楚地展现出他们在人工智能硬件上面的优化本事到底有多强。
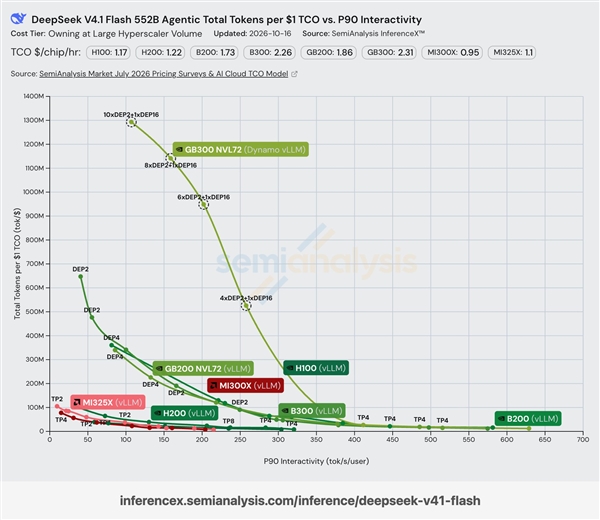
咱们拿这张图来做对比, 主要看的是基准测试的情况。测试的环境是在GB300 NVL72以及vLLM这两个平台上面进行的。然后, V4.1 Flash这个模型跑出来的结果是, 每花1美元, 就能生成1.3B个Token。另外, 它的P90交互速度也超过了每分钟每个用户100个tok/s的用户。
把1美元可以买到13亿Token这一情况算一算的话, 100万的Token只要花费0.00077美元, 这样一个价格, 比起V4.1 Flash这个模型的输入价格需要0.15美元来说, 便宜的程度那是非常大的。
当然, 这两个价格实际上也不能被这么简单地进行换算。毕竟, 每1美元能获取13亿Token的Tco成本, 是属于算力端方面的计算结果。而对于API的定价来说, 还需要去考虑很多更为复杂的情况。只不过, 因为拥有超低的成本, 所以他们才具备在这一方面无人能够匹敌的优势。
正因为 V4.1 Flash在成本上面具备了一个让人觉得难以置信的突出优势。所以各大平台也就敢推出极低的价格。在那些价值 10 美元的服务套餐里。现在大家能使用的额度已经大幅度涨到了 80 到 120 美元。
这两天甚至还对外免费开放了。现在在聚合路由平台里面。V4.1 Flash本身所使用的 Token数量都已经达到了百万亿级别的水平。单单这一家服务商所消耗的算力。就已经能够抵得上六七家同行竞争对手加起来的用量总和了。
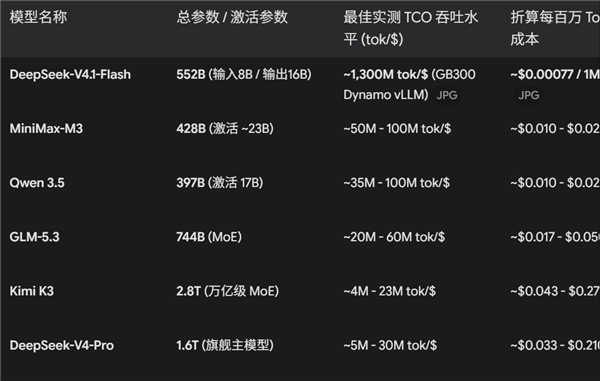
让 AI 对比一下多个开源大模型的总拥有成本之后发现, 那些万亿参数以内的其他大模型, 它们的产出水平, 最高也仅仅能够达到 V4.1 Flash 水平的十分之一, 而如果涉及到那些参数量在 1.5 到 3 万亿之间的大模的话, 那这个成本上的差距, 就更是有可能拉开到 40 倍甚至 50 倍以上了, 这根本就没法直接进行比较。
这一点还需要说明清楚, 这里提到的总拥有成本数据, 其实是基于V4.1版本中Flash-0910这一期的情况计算的, 并不是指今天刚刚发布的1017版。虽说在API定价方面两者没有发生变化, 但是新版本对Token使用效率进行了大幅度的优化工作。
这种优化直接导致了Token实际消耗量的减少, 而在不同任务场景下, 这种效果表现出了一定程度的差异。从使用者最直观的感受来看整体消耗量至少下降了一半以上, 这就意味着总拥有成本在未来的应用中将有机会实现再一次显著的大幅降低。