Claude禁止辱骂AI?Anthropic新政策:反复无意义攻击会被拉黑
智能摘要
Anthropic修订Claude使用政策,新增禁止持续无必要辱骂或残酷对待模型的规定,计划11月12日生效。该规定针对极端情形,不涵盖正当表达、反驳、创作或测试等互动。政策同时确认模型可结束持续辱骂等恶意对话,但仅针对持续无必要行为,非每次负面评价都会受处理。
公司是在10月8日这一天, 正式对外宣布要对使用政策进行修订的。在这次更新里面, 特地新增了一条规定, 这条规定明确指出, 严禁用户对模型进行那种持续性的、而且完全没有必要的辱骂行为, 同时也严厉禁止对模型实施任何残酷对待的行为。关于这个全新的条款内容, 计划在11月12日这一天开始正式生效执行。
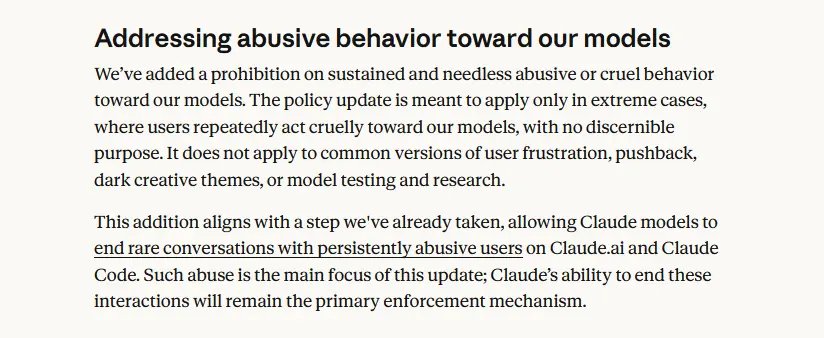
这项规定它只管那个反复、没什么明确目标, 就去做出那些非常残酷的言行的极端情况。它不是把那种激烈的表达全都包括进去。比如那些正当的发泄不满的办法, 或者反过来反驳那个模型给出的答复, 还有为了创作, 或者为了测试模型, 或者是搞研究去和它互动, 这些情况都被列在了不适用这条规定的那一个类别里。
这次修订把一项已经存在的做法写进了政策里面, 那就是说, 如果面对像持续辱骂这样不好的互动情况, 模型是可以结束对话的, 针对的是那些一直不停而且没有必要的行为, 这意思并不是说遇到任何一次负面的评价或者是批评就要用一样的办法来处理。